2025 · CONNECTORS
Ανάλυση Ομιλιών της Ελληνικής Βουλής (1989–2020)
Έργο ανάλυσης δεδομένων και ανάκτησης πληροφορίας πάνω σε 1,2 εκατομμύρια ομιλίες της Ελληνικής Βουλής (1989–2020).
- Python
- Pandas
- NumPy
- NLTK
- scikit-learn
- Flask
- HTML
- CSS
- JavaScript
- Πρόβλημα
- 1.280.918 ομιλίες της Ελληνικής Βουλής από 5.355 συνεδριάσεις (1989–2020) σε ένα CSV 2,30 GB: πολύ μεγάλο για να διαβαστεί, να αναζητηθεί ή να συγκριθεί.
- Τι έφτιαξα
- Μαζί με την ομάδα μου, μια μηχανή αναζήτησης για τις ομιλίες, εξαγωγή λέξεων-κλειδιών με την εξέλιξή τους στον χρόνο, ομοιότητα μεταξύ βουλευτών, θεματική ανάλυση LSI και clustering, μέσα από μια web εφαρμογή σε Flask.
- Αποτέλεσμα
- Τρεις δεκαετίες πολιτικού λόγου έγιναν αναζητήσιμες με λέξη-κλειδί, ομιλητή ή ημερομηνία, με τα βασικά θέματα και τους πιο παρόμοιους βουλευτές ορατά με μια ματιά.
Το έργο αυτό υλοποιήθηκε στο πλαίσιο του μαθήματος «Ανάκτηση Πληροφορίας», με αντικείμενο την ανάλυση όλων των ομιλιών της Ελληνικής Βουλής από το 1989 έως το 2020.
Σύνολο Δεδομένων
Το σύνολο δεδομένων προήλθε από το GitHub αποθετήριο της Βουλής και περιλάμβανε 1.280.918 ομιλίες βουλευτών (συνολικά 2,30 GB), προερχόμενες από 5.355 συνεδριάσεις.
Κάθε εγγραφή περιείχε στοιχεία όπως όνομα ομιλητή, πολιτικό κόμμα, ημερομηνία, και στοιχεία συνεδρίασης.
Το αρχείο ήταν UTF-8 CSV και αποτέλεσε τη βάση για μια σειρά αναλύσεων.
Υλοποιημένες Ενότητες
- Διαδικτυακή Εφαρμογή Αναζήτησης:
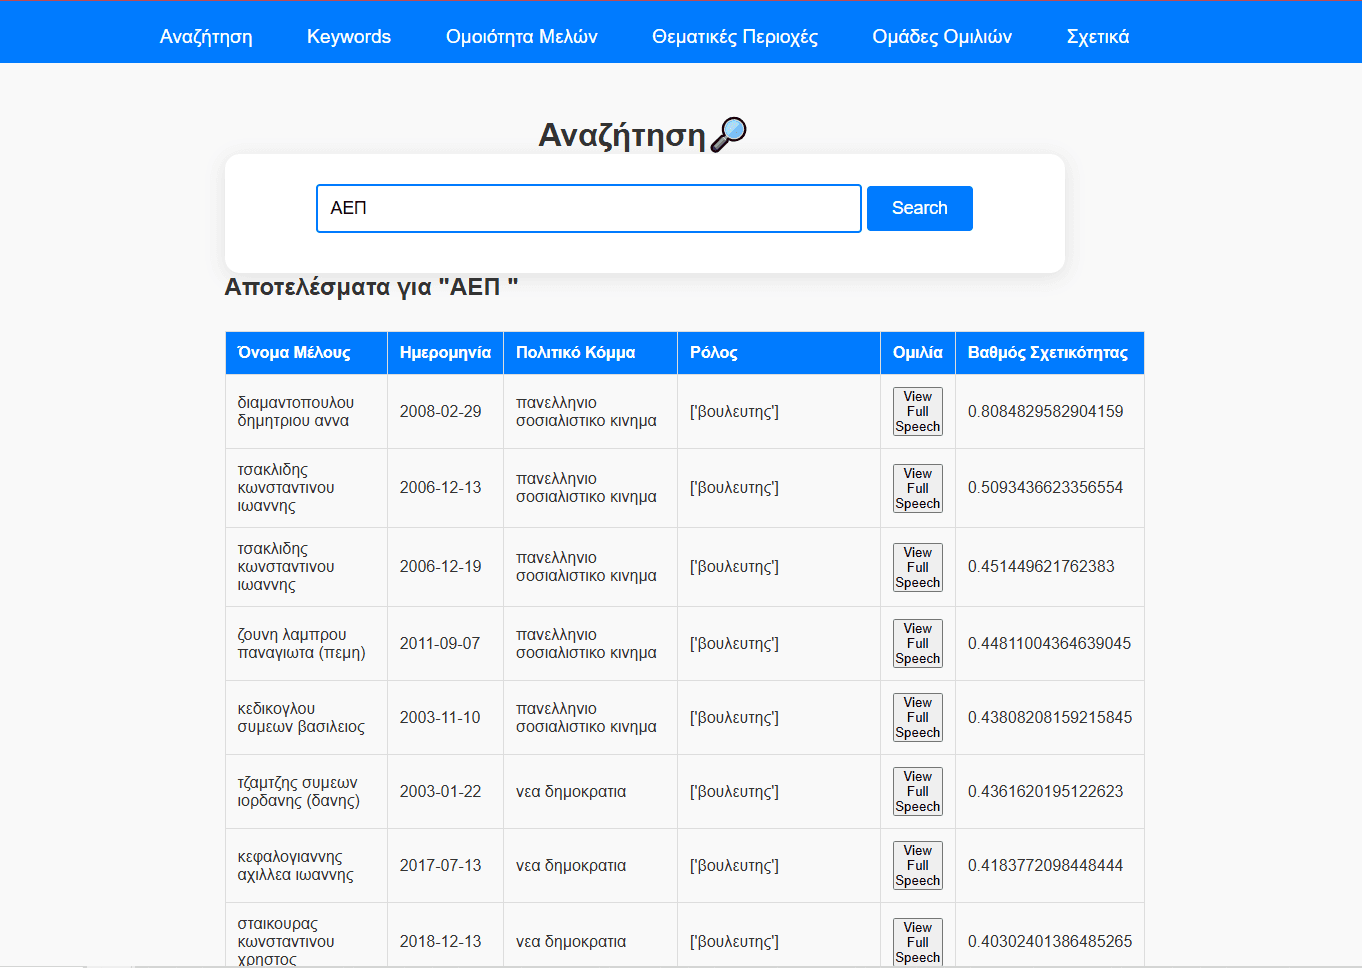
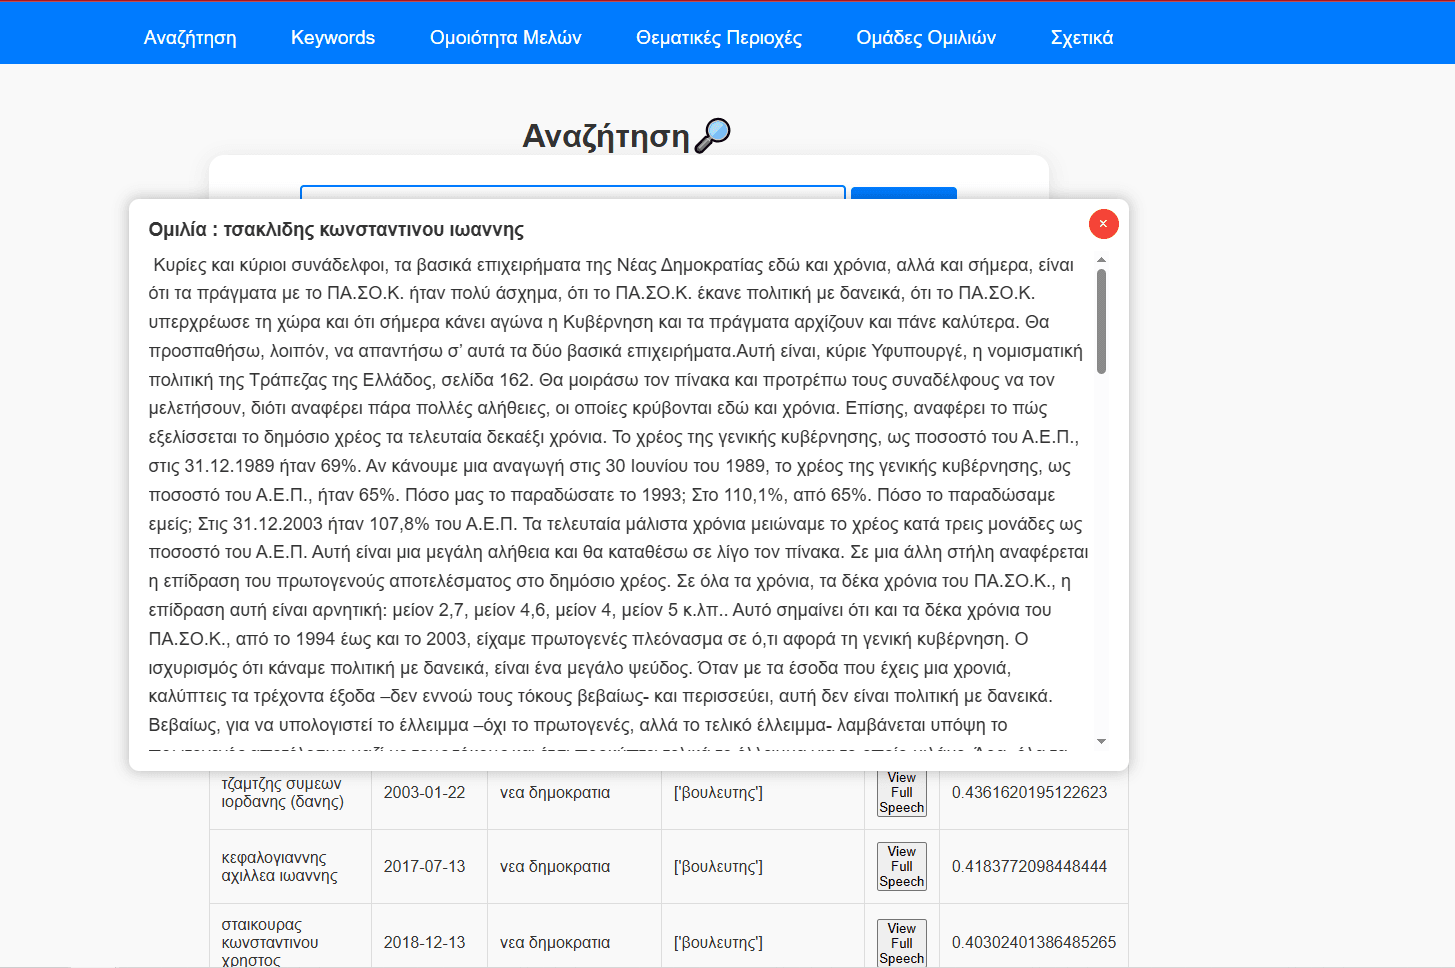
Αναπτύχθηκε web εφαρμογή που λειτουργεί ως μηχανή αναζήτησης για τις ομιλίες, επιτρέποντας αναζήτηση βάσει λέξεων-κλειδιών, ομιλητή ή ημερομηνίας. ()
- Εξαγωγή Λέξεων-Κλειδιών & Χρονική Ανάλυση:
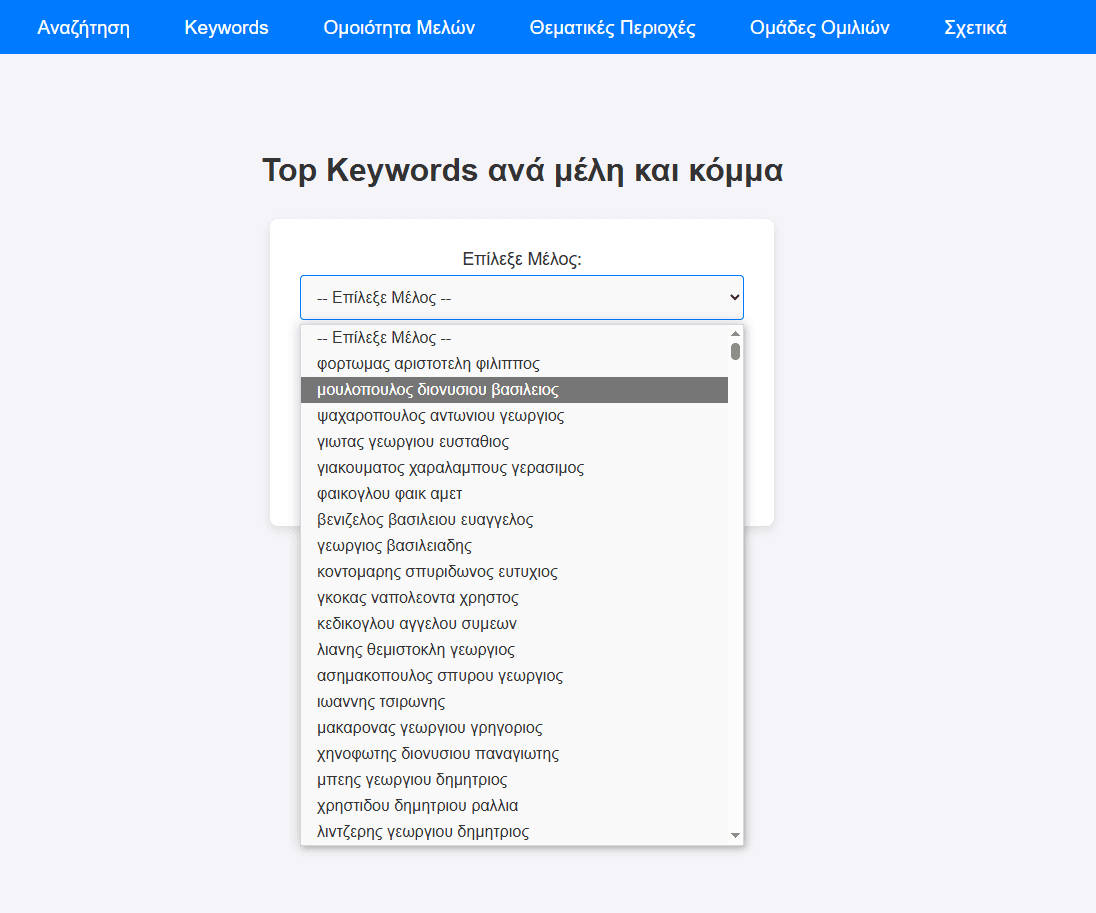
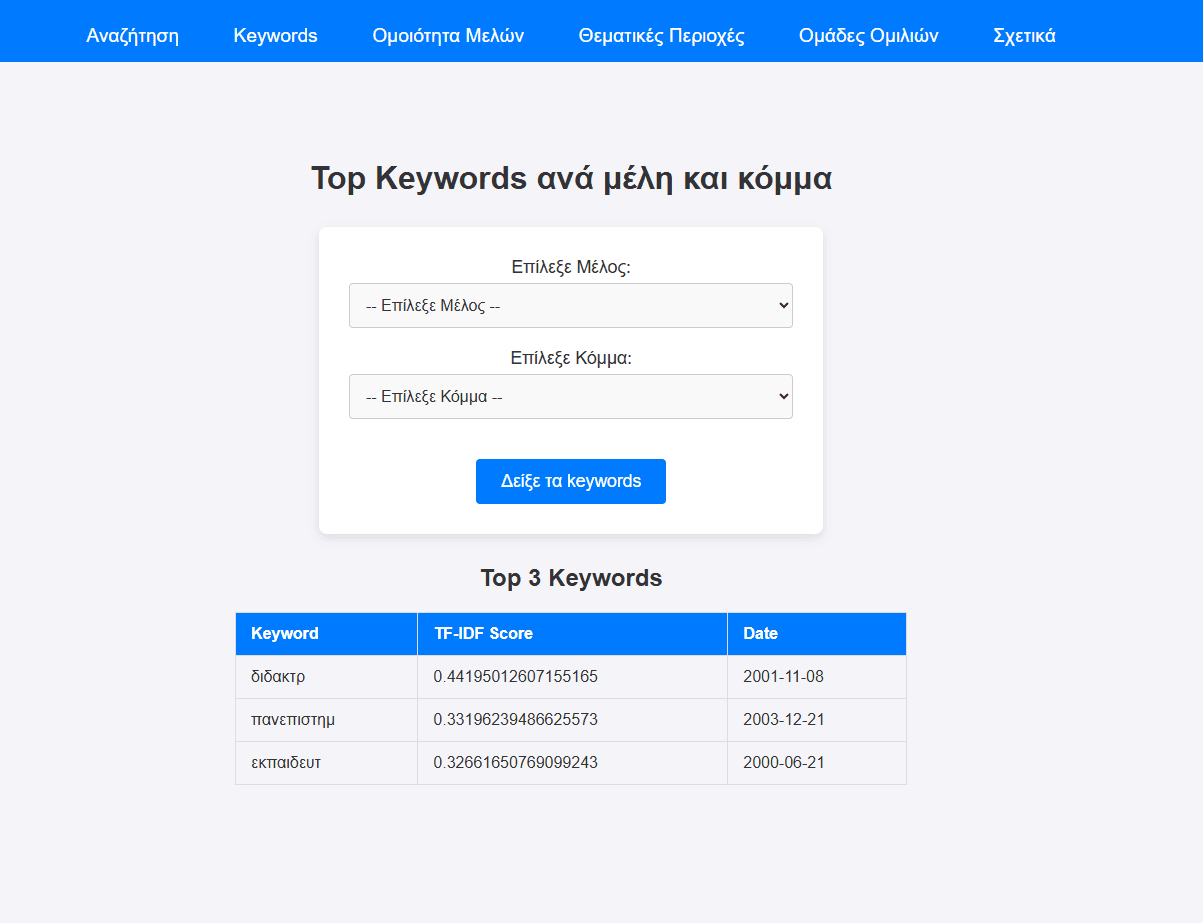
Για κάθε ομιλία, βουλευτή και κόμμα εντοπίστηκαν οι σημαντικότερες λέξεις-κλειδιά και μελετήθηκε η εξέλιξή τους στο χρόνο, με απεικόνιση των τάσεων.
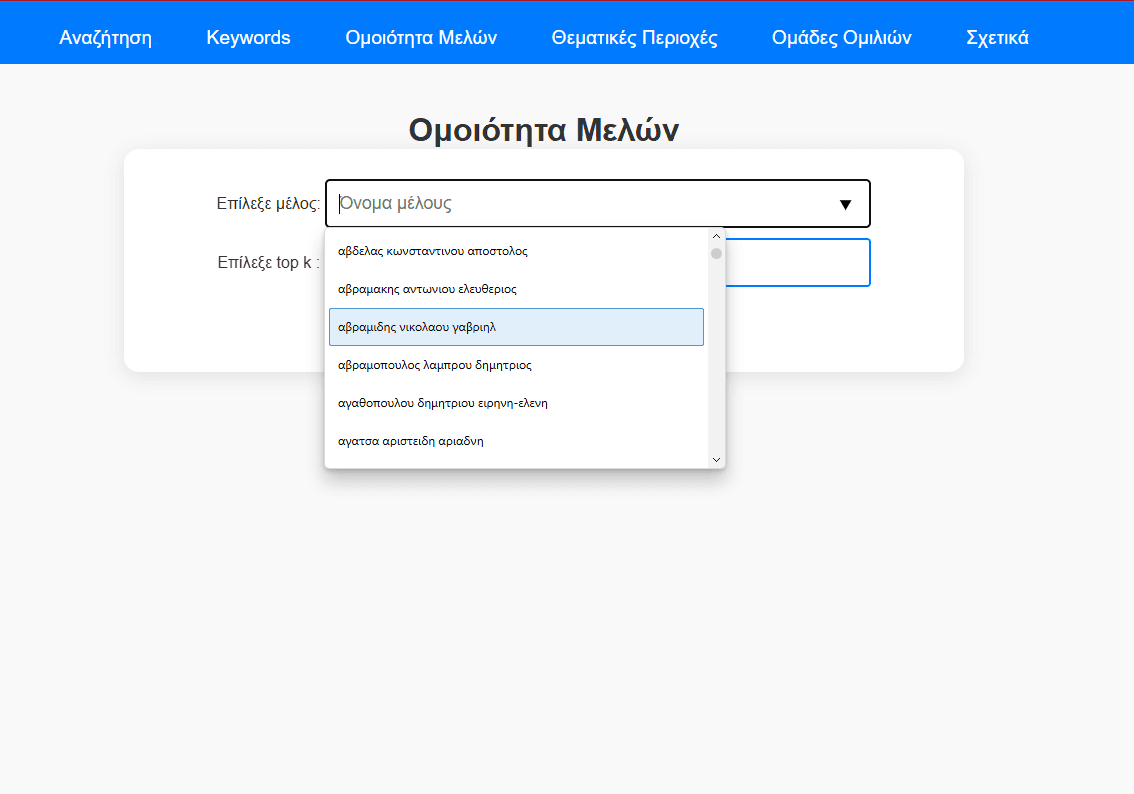
- Εύρεση Ομοιότητας Βουλευτών:
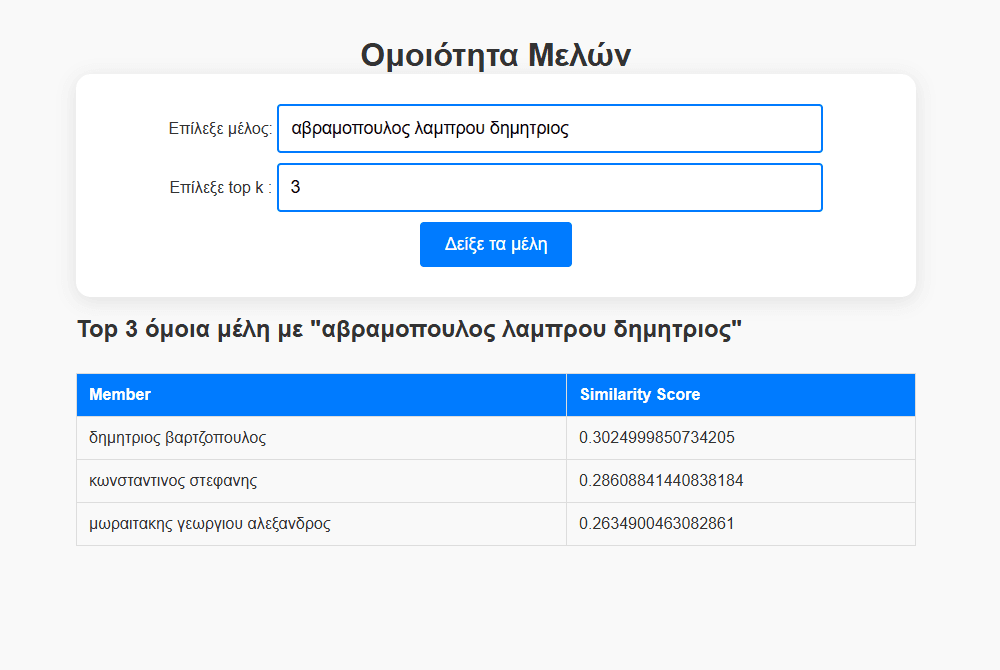
Δημιουργήθηκαν διανύσματα χαρακτηριστικών για κάθε βουλευτή, υπολογίστηκαν οι ζεύγη ομοιότητας, και εντοπίστηκαν οι top-k πιο παρόμοιοι βουλευτές.
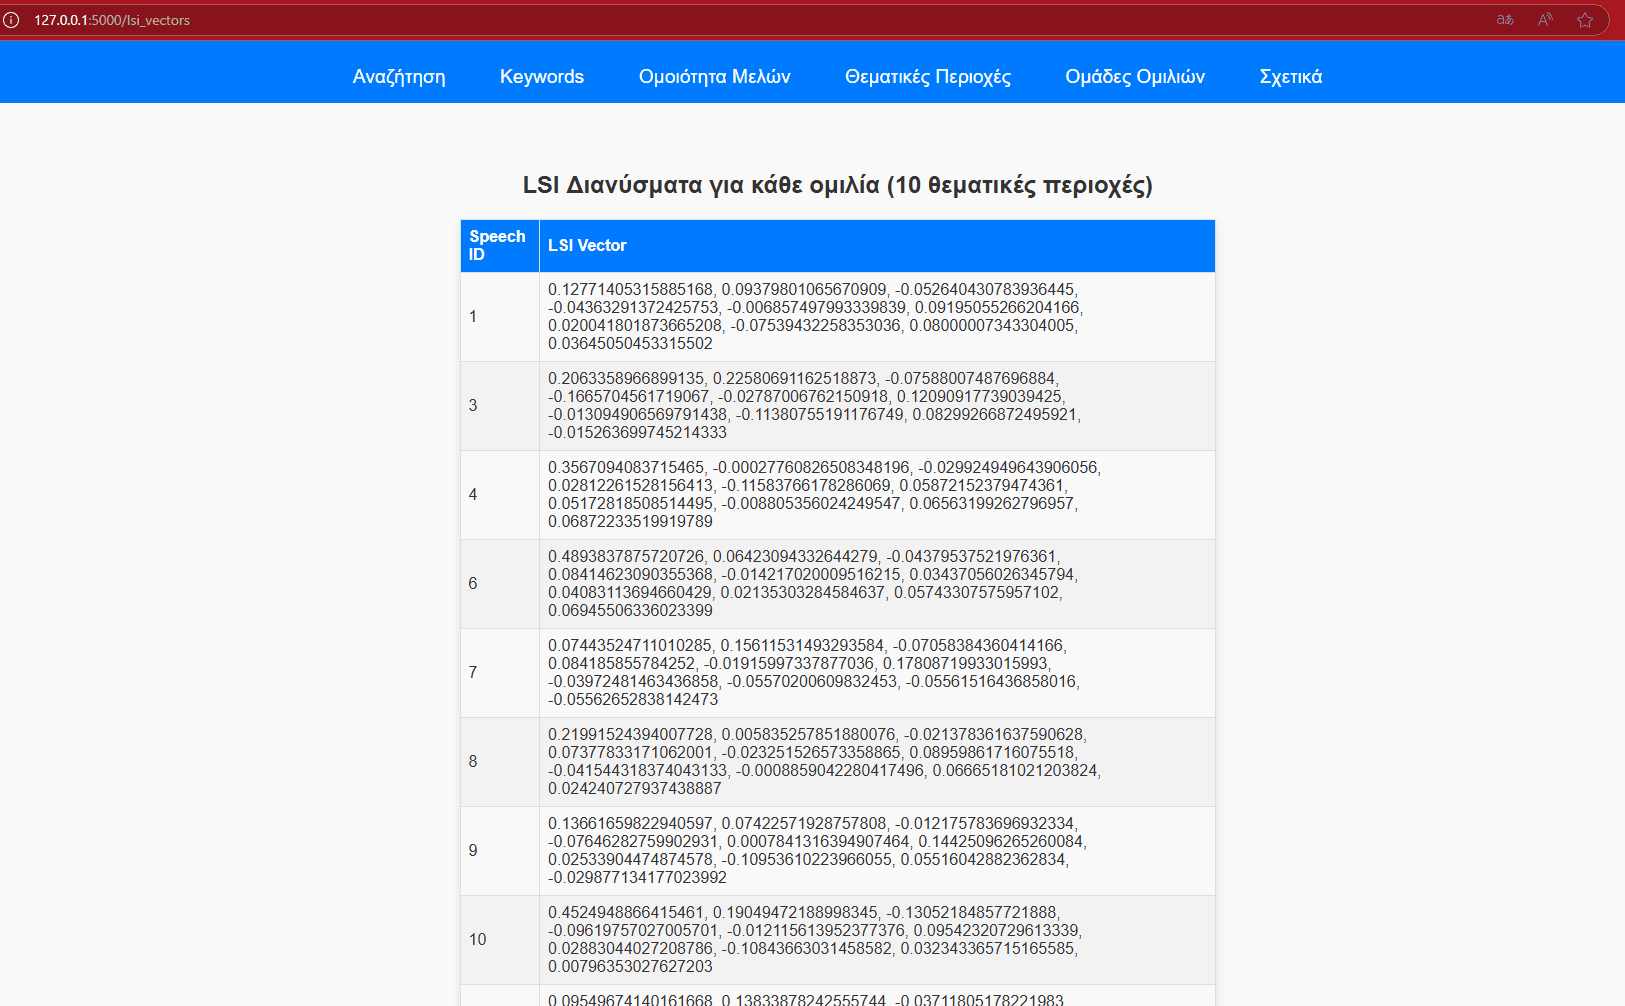
- Ανάλυση Λανθανουσών Σημασιολογικών Διαστάσεων (LSI):
Εφαρμόστηκε η μέθοδος LSI για τον εντοπισμό θεματικών περιοχών και την αναπαράσταση κάθε ομιλίας σε πολυδιάστατο σημασιολογικό χώρο.
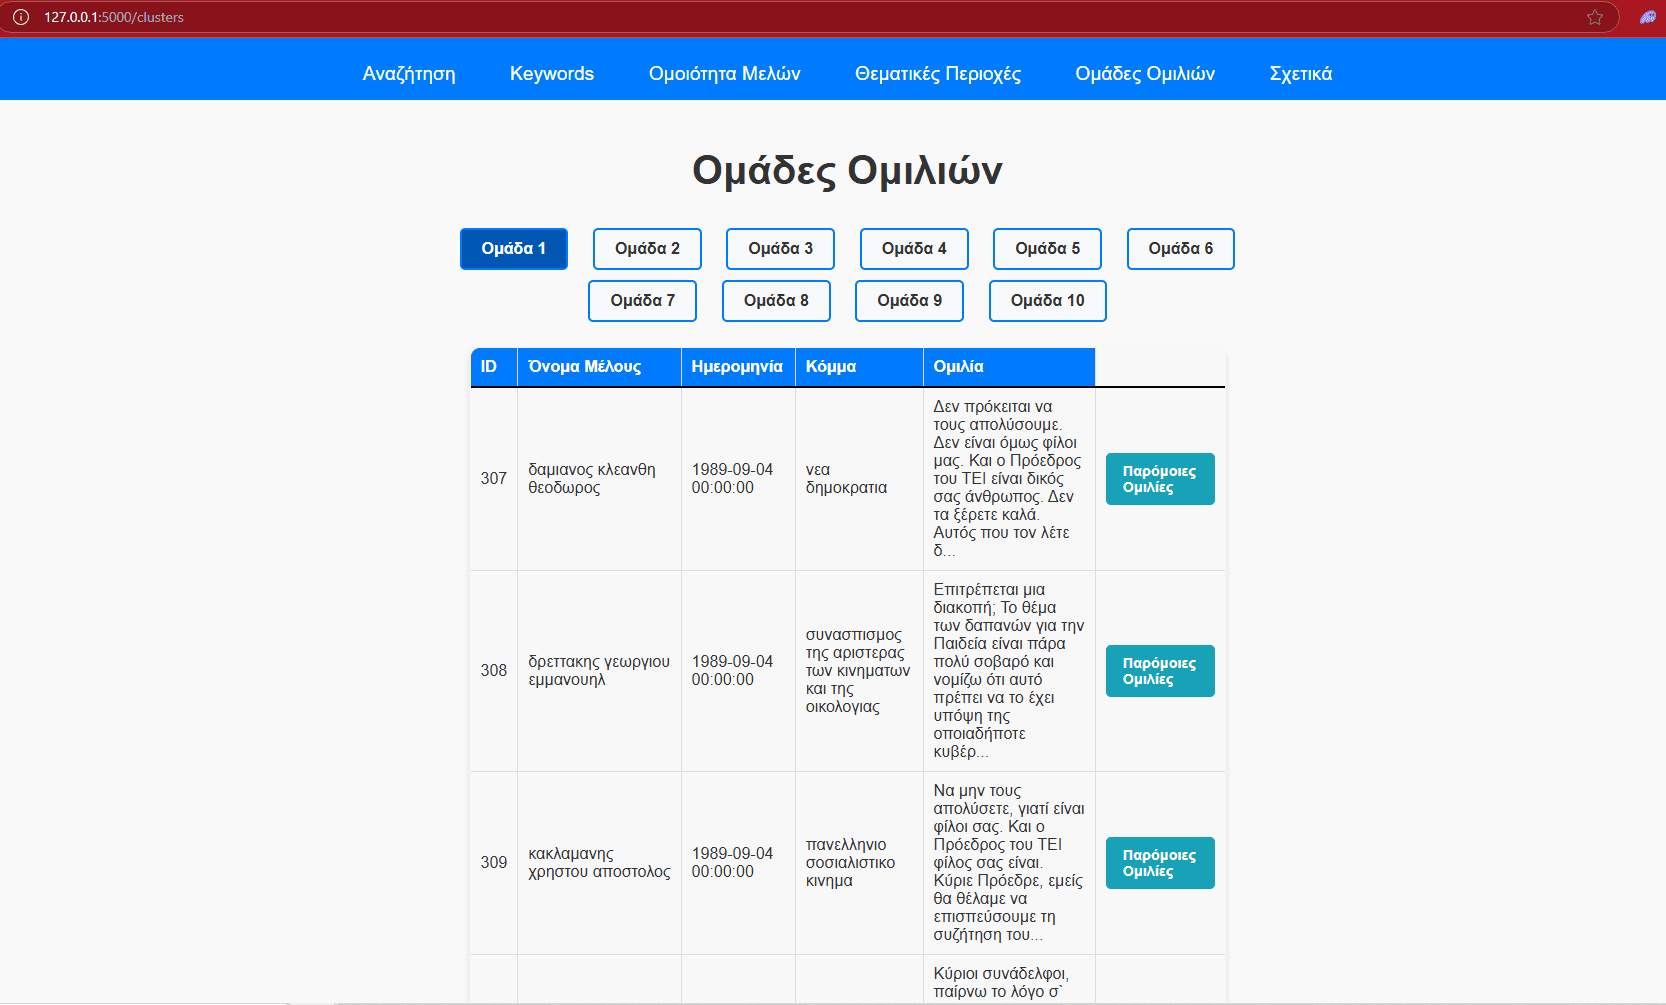
- Ομαδοποίηση Ομιλιών:
Πραγματοποιήθηκε clustering ώστε οι ομιλίες με υψηλή εσωτερική ομοιότητα να ομαδοποιηθούν, αποκαλύπτοντας θεματικά μοτίβα και πολιτικές τάσεις.
- Προαιρετική Πρόσθετη Ανάλυση:
Η ομάδα μας πρότεινε και υλοποίησε μια επιπλέον ανάλυση, ειδικά προσαρμοσμένη στο dataset, η οποία παρήγαγε ενδιαφέροντα και ουσιαστικά αποτελέσματα.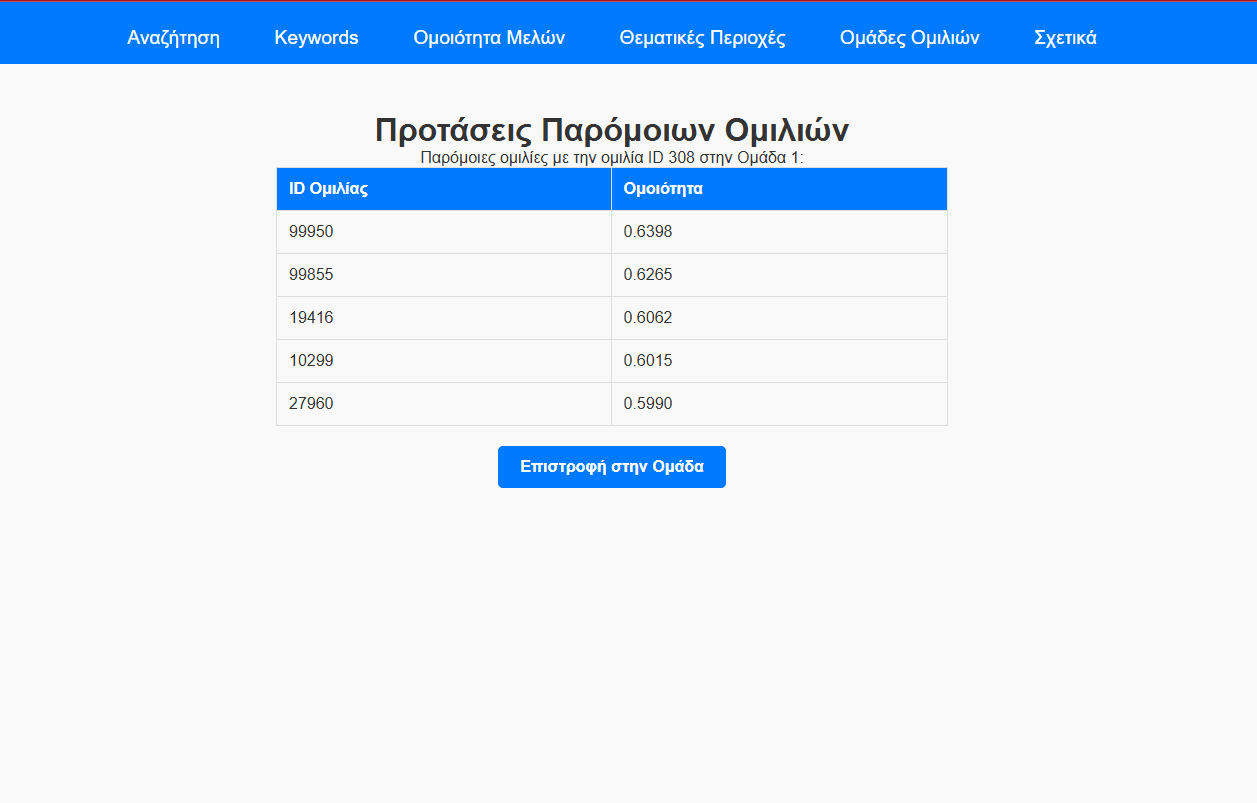
Το έργο αυτό αναδεικνύει δεξιότητες σε ανάλυση δεδομένων, επεξεργασία φυσικής γλώσσας και ανάκτηση πληροφορίας, συνδυάζοντας θεωρητικές μεθόδους με πρακτική web εφαρμογή για εξερεύνηση πολιτικού λόγου.